紫东太初推出GMC核心集剪枝方法,少80%Token仍满血保真多模态能力
Ranking
Overall
61
Content
65
Popularity
50
Observed public metrics from 1 member.
Merged summary
TL;DR - 中科院自动化所紫东太初团队发布 GMC(Grounded Message Coreset Pruning),一种免训练的视觉 Token 核心集剪枝方法,可在删除 80–90% 视觉 Token 的情况下保持接近原模型的多模态能力,直指高分辨率 VLM 的显存与推理成本瓶颈。
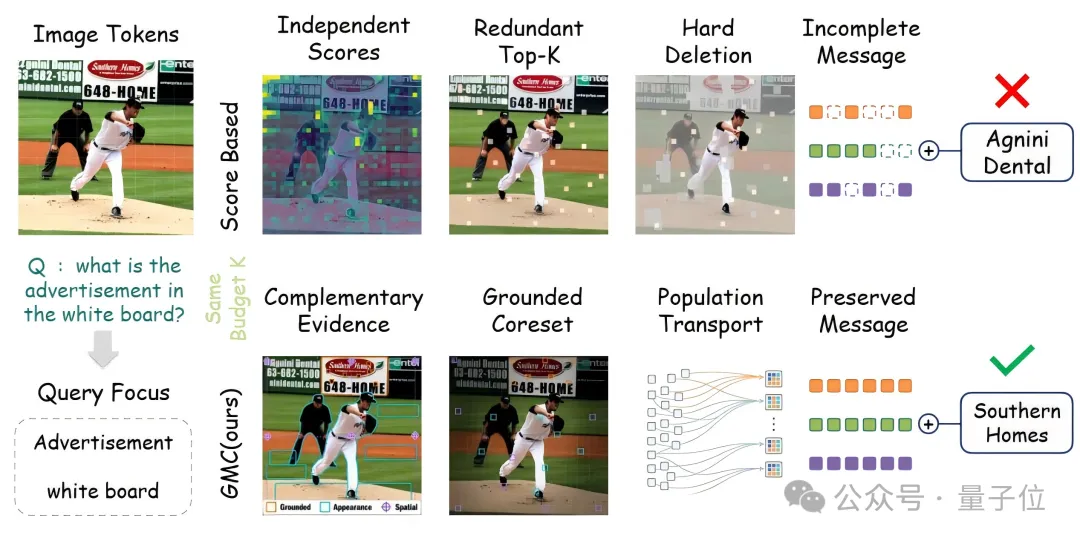
- 双阶段设计:先做"互补证据自适应筛选"(结合问题—视觉注意力、视觉特征相似性、原始图像坐标空间证据),按对未覆盖证据的边际贡献选 Token,避免 Top-K 反复保留同质化显著区域;再用 Population Transport 把待删 Token 的隐藏状态按特征相似度与空间邻近性迁移到代表 Token。
- 实测结果:Qwen2.5-VL-7B 上从 1296 个视觉 Token 减到 256(-80.2%)保留 97.78% 平均性能,减到 128(-90.1%)的 GMC-L16 达 99.11%;LLaVA-1.5-7B 保留 128/64 个 Token 时分别为 99.76%/99.82%。
- 长文档场景:15876 个原始视觉 Token 输入下保持 98.87% 问答质量,端到端推理加速 1.258 倍,提示 KV Cache 减少 73.94%——因为是真实序列压缩而非掩码遮蔽。
- 免训练、无需任务标签/OCR/检测器等外部依赖,可直接接入 Qwen、LLaVA 等主流 VLM;在 POPE、AMBER、HallusionBench、CHAIR 等幻觉基准上事实一致性优于同预算基线。论文:arXiv 2608.02134v1。
Sources (1)
紫东太初推出GMC核心集剪枝方法,少80%Token仍满血保真多模态能力
Public signals
Semantic Scholar citations 0 · Semantic Scholar influential citations 0
TL;DR - 中科院自动化所紫东太初团队发布 GMC(Grounded Message Coreset Pruning),一种免训练的视觉 Token 核心集剪枝方法,可在删除 80–90% 视觉 Token 的情况下保持接近原模型的多模态能力,直指高分辨率 VLM 的显存与推理成本瓶颈。
- 双阶段设计:先做"互补证据自适应筛选"(结合问题—视觉注意力、视觉特征相似性、原始图像坐标空间证据),按对未覆盖证据的边际贡献选 Token,避免 Top-K 反复保留同质化显著区域;再用 Population Transport 把待删 Token 的隐藏状态按特征相似度与空间邻近性迁移到代表 Token。
- 实测结果:Qwen2.5-VL-7B 上从 1296 个视觉 Token 减到 256(-80.2%)保留 97.78% 平均性能,减到 128(-90.1%)的 GMC-L16 达 99.11%;LLaVA-1.5-7B 保留 128/64 个 Token 时分别为 99.76%/99.82%。
- 长文档场景:15876 个原始视觉 Token 输入下保持 98.87% 问答质量,端到端推理加速 1.258 倍,提示 KV Cache 减少 73.94%——因为是真实序列压缩而非掩码遮蔽。
- 免训练、无需任务标签/OCR/检测器等外部依赖,可直接接入 Qwen、LLaVA 等主流 VLM;在 POPE、AMBER、HallusionBench、CHAIR 等幻觉基准上事实一致性优于同预算基线。论文:arXiv 2608.02134v1。